Logiciel Bilan Carbone
 Logiciel ACV
 Plateforme ESG
 Collecte fournisseurs
Les centres de données dédiés à l'intelligence artificielle ont consommé environ 155 TWh d'électricité en 2025, et cette consommation doit tripler d'ici 2030.
Cette croissance ne se limite pas aux géants américains du cloud. En France, RTE (Réseau de transport d'électricité) anticipe une consommation des centres de données multipliée par deux à trois d'ici 2035, portée en bonne partie par les charges de travail liées à l'intelligence artificielle (IA). Pour une entreprise qui utilise des outils d'IA générative au quotidien, ce poste reste pourtant largement invisible dans son bilan carbone, faute d'être isolé des autres achats de services numériques.
Cet article fait le point sur les chiffres vérifiables de l'impact environnemental de l'IA, du niveau mondial jusqu'à l'échelle d'une requête, sur le cadre réglementaire qui s'applique déjà aux centres de données et, depuis 2025, aux fournisseurs de modèles, et sur la façon de comptabiliser ce poste dans le bilan carbone d'une entreprise.
 En bref
- L'impact environnemental de l'IA recouvre deux postes distincts : l'entraînement des modèles (ponctuel, très énergivore) et l'inférence, c'est-à-dire l'utilisation au quotidien (récurrente, plus modeste à l'unité mais massive en volume cumulé).
- Consommation électrique mondiale des centres de données : environ 485 TWh en 2025, projection 950 TWh en 2030 ; les centres dédiés à l'IA pèsent déjà environ 32 % de ce total et doivent tripler sur la période (AIE, avril 2026).
- En France, RTE prévoit une consommation des data centers passant d'environ 10 TWh aujourd'hui à 23-28 TWh en 2035, tirée en bonne partie par l'IA.
- Au niveau d'une requête, les ordres de grandeur communiqués par OpenAI et Google restent modestes (0,24 à 0,34 Wh), loin du coût de l'entraînement d'un grand modèle (plus de 1 000 MWh pour GPT-3 selon une étude de 2021 ; environ 20,4 ktCO2e pour Mistral Large 2 selon une analyse de cycle de vie plus récente, juillet 2025).
- Les centres de données sont déjà soumis à une obligation de reporting énergétique européenne, et depuis août 2025 les fournisseurs de modèles d'IA à usage général doivent documenter la consommation d'énergie de l'entraînement ; pour l'entreprise utilisatrice, l'IA relève du scope 3 de son bilan carbone, un poste encore rarement isolé.
Ce que recouvre l'impact environnemental de l'IA
L'impact environnemental de l'intelligence artificielle se mesure à plusieurs niveaux, qu'il faut distinguer pour éviter de confondre des ordres de grandeur très différents.
Le premier niveau est l'entraînement d'un modèle : la phase de calcul intensif, sur plusieurs semaines ou mois, qui ajuste les paramètres du modèle à partir de grands volumes de données. Cette phase est ponctuelle (elle ne se reproduit qu'à chaque nouvelle version du modèle) mais extrêmement consommatrice en électricité.
Le second niveau est l'inférence : l'utilisation du modèle déjà entraîné pour répondre à une requête. Chaque requête individuelle consomme peu, mais le volume cumulé de milliards de requêtes quotidiennes change l'échelle du problème.
Le troisième niveau, souvent oublié, est la fabrication du matériel (puces graphiques, serveurs, infrastructures réseau) et la construction des centres de données eux-mêmes, qui mobilisent des ressources (métaux, eau, énergie) en amont de toute utilisation.
La consommation électrique des centres de données, du monde à la France
Au niveau mondial, l'Agence internationale de l'énergie (AIE) a publié en avril 2026 son rapport « Key Questions on Energy and AI », qui actualise ses projections. Selon ce rapport, la consommation électrique de l'ensemble des centres de données s'est élevée à environ 485 TWh en 2025, avec une projection à 950 TWh en 2030, soit environ 3 % de la demande électrique mondiale à cette date.
Sur ces 485 TWh de 2025, les centres de données dédiés spécifiquement à l'IA (entraînement et inférence des modèles) en ont consommé environ 155 TWh, soit environ 32 % du total. L'AIE anticipe que cette part dédiée à l'IA triple d'ici 2030, une croissance plus rapide que celle des centres de données pris dans leur ensemble.
En France, RTE publie régulièrement ses propres projections. Selon le « Bilan prévisionnel de l'équilibre offre-demande d'électricité 2025-2035 » (décembre 2025), les centres de données français consomment aujourd'hui environ 10 TWh, soit environ 2 % de la consommation électrique nationale. RTE prévoit une consommation de 15 à 20 TWh en 2030 (environ 3 %), puis de 23 à 28 TWh en 2035 (environ 4 %).
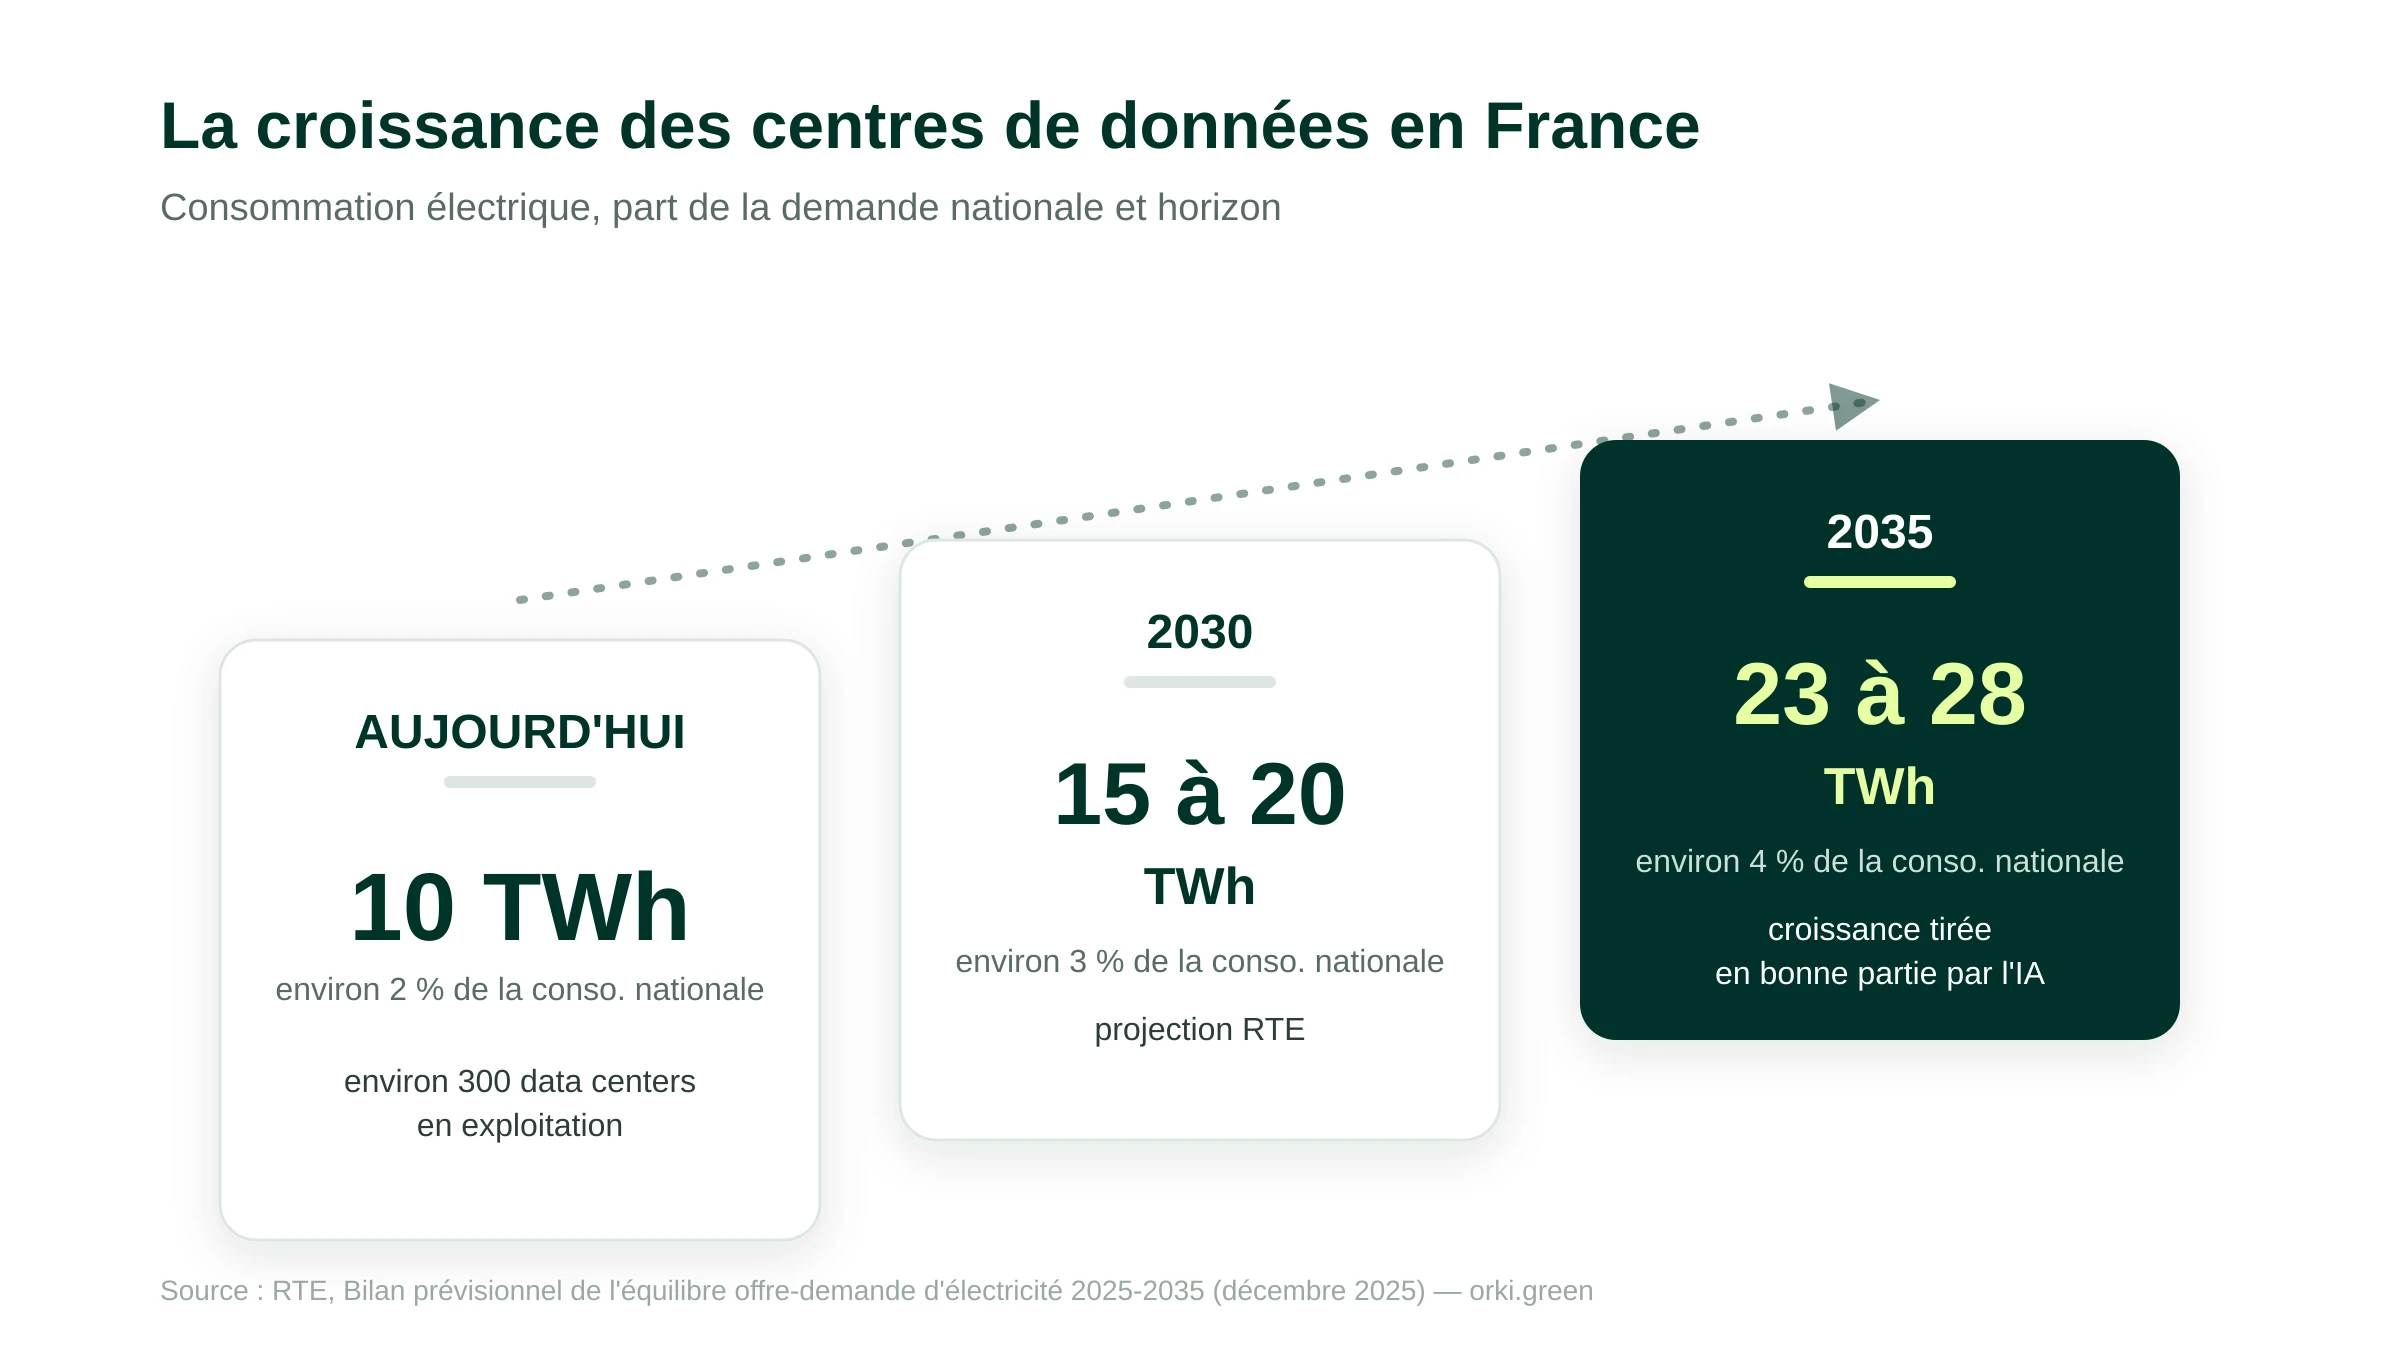
Cette trajectoire ne dit pas que l'IA est l'unique moteur de la croissance des data centers (le cloud et le streaming vidéo y contribuent aussi), mais RTE comme l'AIE identifient tous deux l'IA comme son principal facteur d'accélération sur la période récente.
Ce que consomme l'IA à l'usage : de la requête à l'entraînement
Une requête : les chiffres communiqués par OpenAI et Google
Au niveau macro, les chiffres de l'AIE et de RTE portent sur l'ensemble des centres de données. Au niveau micro, deux éditeurs d'IA générative ont publié leurs propres estimations par requête.
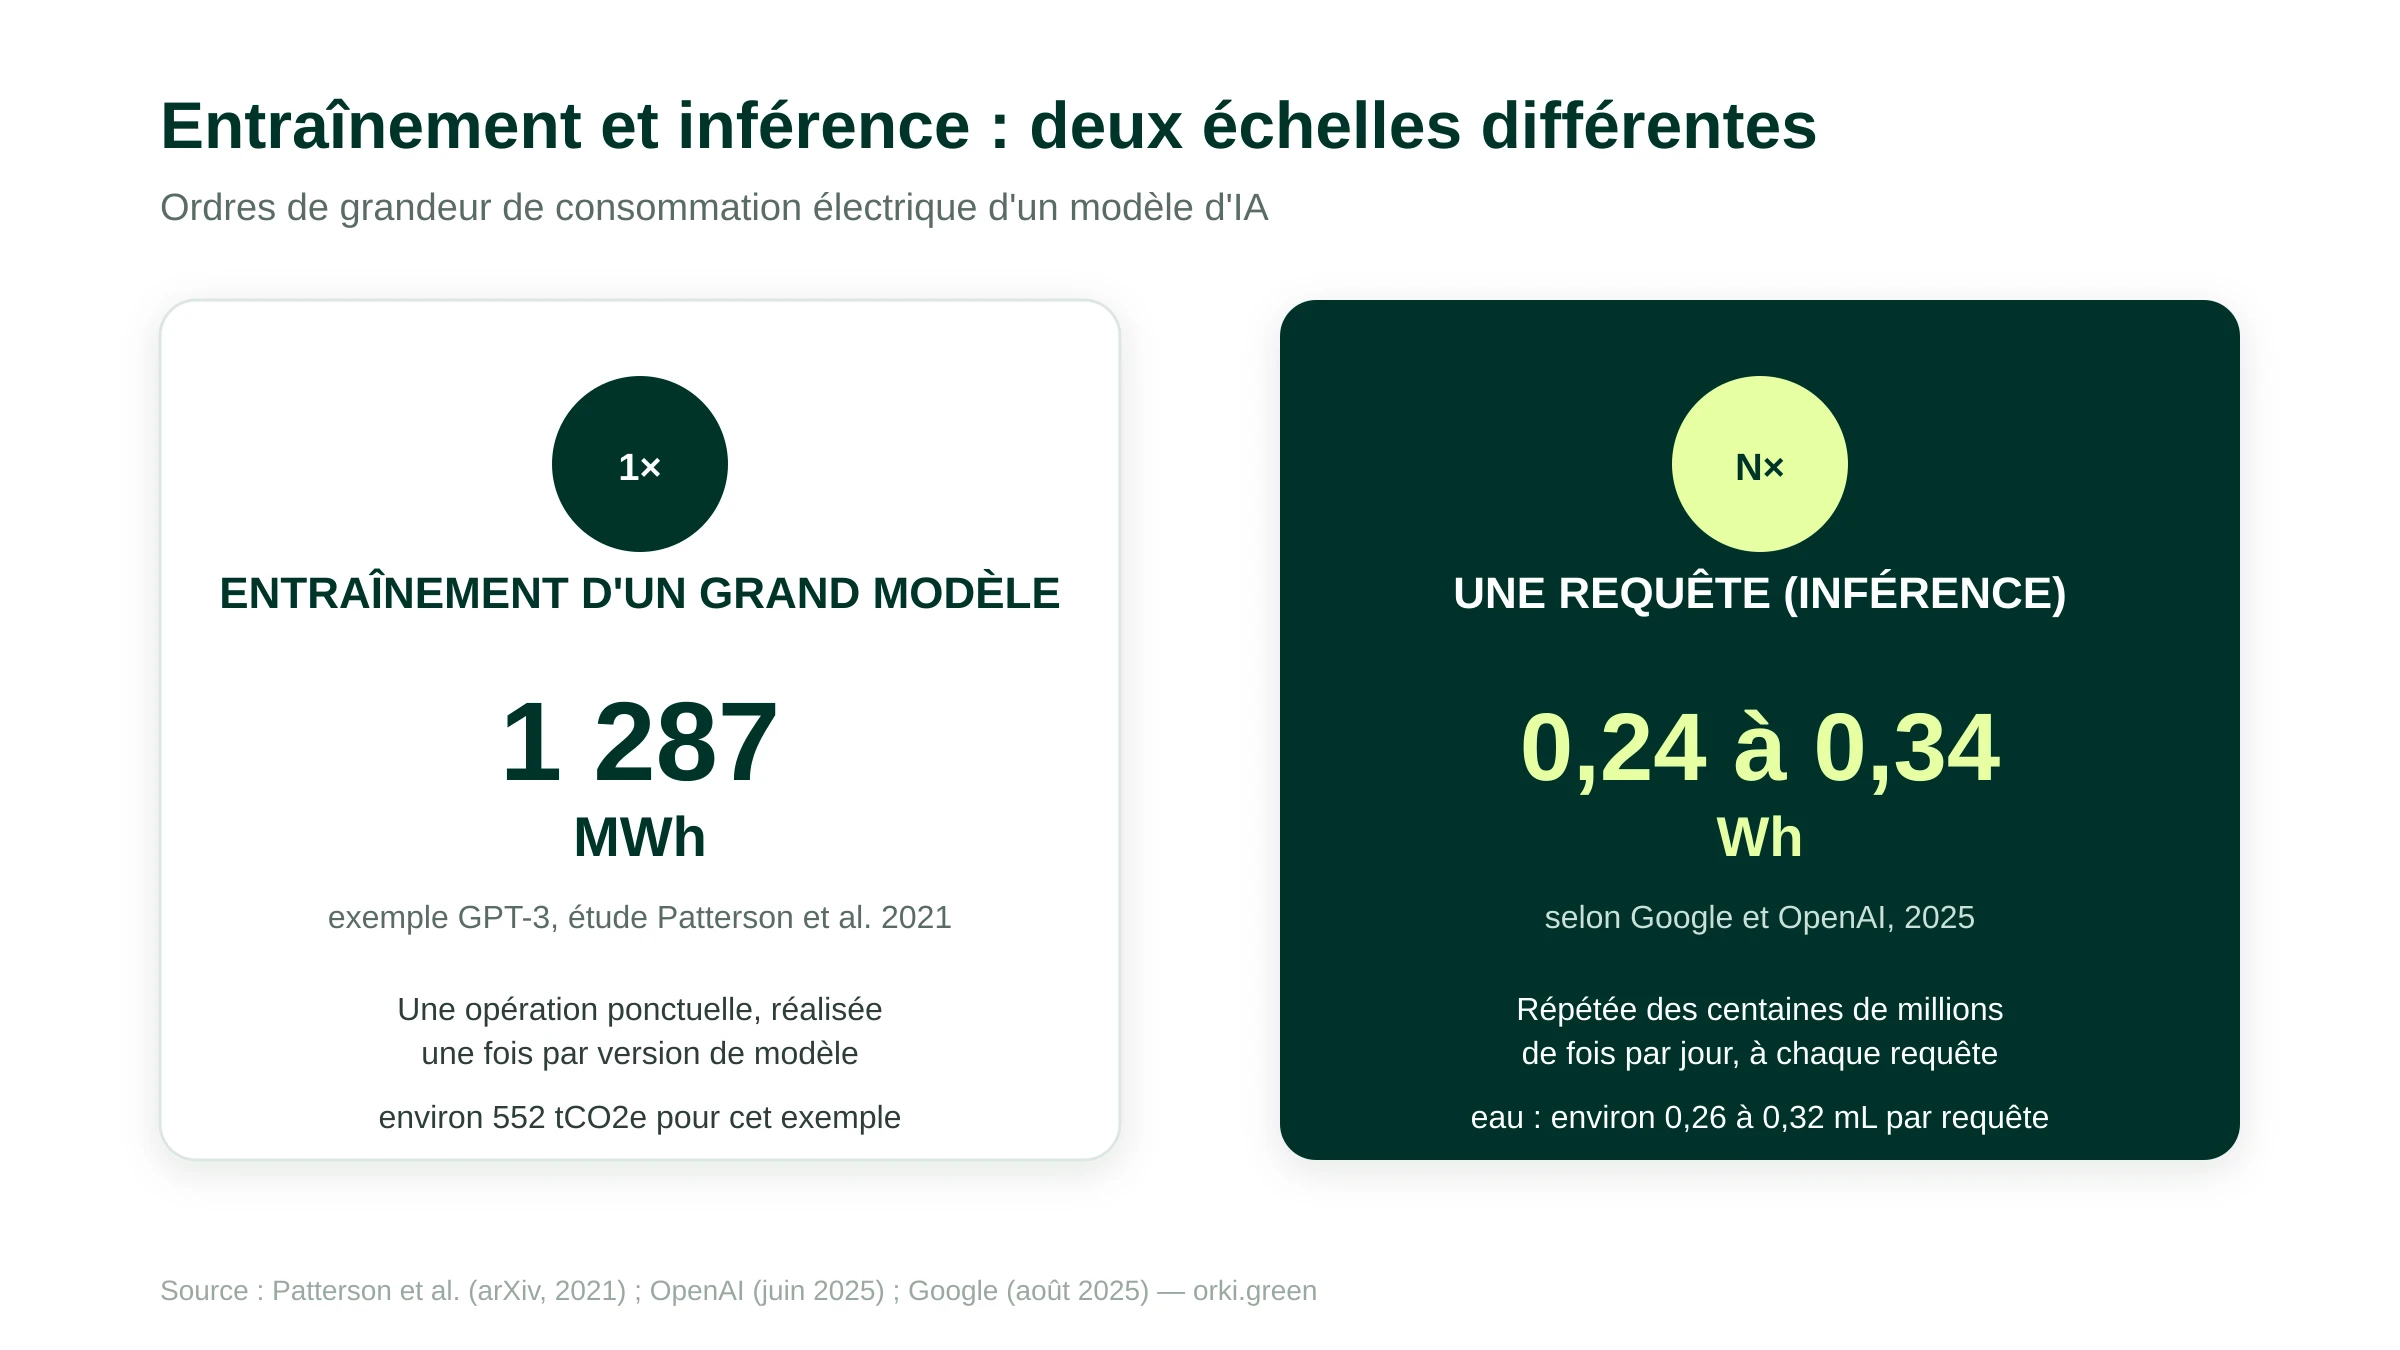
OpenAI a communiqué en juin 2025, par la voix de son directeur général Sam Altman, un ordre de grandeur : une requête moyenne sur ChatGPT consommerait environ 0,34 Wh d'électricité et environ 0,32 mL d'eau. Le périmètre exact de cette « requête moyenne » (type de requête, inclusion ou non du coût de l'entraînement du modèle) n'est pas précisé publiquement par l'entreprise, et le chiffre n'a pas fait l'objet d'une publication scientifique revue par des pairs.
Google a publié en août 2025 un document technique plus détaillé sur son modèle Gemini : une requête texte médiane y consommerait environ 0,24 Wh d'électricité, émettrait environ 0,03 g de CO2e et utiliserait environ 0,26 mL d'eau.
Ces deux chiffres, du même ordre de grandeur, restent modestes à l'échelle d'une requête isolée : de l'ordre de la consommation d'une ampoule basse consommation allumée quelques minutes. Mais ils sont communiqués par les éditeurs eux-mêmes, sans méthodologie indépendante publiée pour les vérifier intégralement, et ne couvrent que l'inférence, pas l'entraînement du modèle en amont.
L'entraînement des modèles, un poste à part
L'entraînement d'un grand modèle de langage se distingue nettement de l'inférence par son échelle et sa récurrence. Une étude académique de référence, publiée en 2021 par une équipe associant Google et l'université de Californie à Berkeley (Patterson et al., « Carbon Emissions and Large Neural Network Training »), a documenté le coût de l'entraînement de plusieurs grands modèles de l'époque. Pour GPT-3, l'étude estime une consommation électrique de l'ordre de 1 287 MWh, pour environ 552 tCO2e.
Ce chiffre date de 2021 et porte sur un modèle déjà ancien : il n'est pas directement transposable aux modèles entraînés en 2025-2026, dont la taille et l'efficacité ont évolué dans des directions opposées (modèles plus grands d'un côté, optimisations matérielles et logicielles de l'autre). Une étude plus récente et méthodologiquement plus complète existe désormais pour un modèle français : Mistral AI a publié en juillet 2025 une analyse de cycle de vie de Mistral Large 2, réalisée avec le cabinet de conseil Carbone 4 et avec l'appui de l'ADEME. Sur l'entraînement et 18 mois d'usage, l'étude chiffre l'impact à environ 20,4 ktCO2e, 281 000 m³ d'eau et 660 kg d'équivalent antimoine (indicateur d'épuisement des ressources abiotiques) ; à l'usage, une réponse de 400 tokens générée par l'assistant Le Chat représente environ 1,14 gCO2e et environ 45 mL d'eau.
Ce qu'il illustre reste valable : l'entraînement d'un grand modèle représente un pic de consommation ponctuel, de plusieurs centaines à plus d'un millier de mégawattheures (ou, en équivalent carbone, plusieurs dizaines de milliers de tonnes de CO2e pour un entraînement complet comme celui de Mistral Large 2) en une seule opération, quand une requête individuelle se compte en dixièmes de wattheure ou en grammes de CO2e. C'est cette asymétrie qui explique pourquoi les deux postes (entraînement, inférence) doivent être distingués dans toute discussion sur l'impact environnemental de l'IA.
L'eau, un angle souvent oublié
Le refroidissement des centres de données mobilise aussi de l'eau, en complément de l'électricité. Les chiffres communiqués par OpenAI (environ 0,32 mL par requête) et Google (environ 0,26 mL par requête) intègrent cette composante, mais ne distinguent pas toujours l'eau prélevée directement pour le refroidissement de l'eau mobilisée indirectement pour produire l'électricité consommée (une centrale thermique ou nucléaire utilise elle-même de l'eau).
Cette distinction compte : selon la méthode retenue, un même centre de données peut afficher une empreinte hydrique très différente. Les 45 mL d'eau par réponse chiffrés par l'étude Mistral AI, nettement supérieurs aux 0,26-0,32 mL communiqués par Google et OpenAI pour une requête, illustrent moins un écart d'efficacité qu'un périmètre de mesure plus large : l'analyse de cycle de vie de Mistral intègre l'eau mobilisée sur l'ensemble de la chaîne (fabrication des puces, construction des infrastructures, production de l'électricité), quand les chiffres par requête des autres éditeurs se limitent le plus souvent au refroidissement direct des centres de données. C'est l'une des raisons pour lesquelles les chiffres publiés par les différents éditeurs d'IA ne sont pas toujours directement comparables entre eux, au-delà de leur ordre de grandeur commun.
L'eau reste, avec l'électricité, l'un des deux leviers que la réglementation européenne cible désormais explicitement pour les centres de données, qu'ils hébergent de l'IA ou d'autres charges de travail.
Le cadre réglementaire des centres de données et des fournisseurs de modèles
Contrairement aux centres de données, l'usage de l'IA par une entreprise ne fait pas l'objet d'une obligation de reporting environnemental public. Depuis le 2 août 2025, l'AI Act (règlement (UE) 2024/1689, article 53 et annexe XI) impose toutefois aux fournisseurs de modèles d'IA à usage général de documenter, dans leur dossier technique, la consommation d'énergie connue ou estimée de l'entraînement de leurs modèles, une information transmise au Bureau européen de l'IA et aux fournisseurs en aval, mais qui n'est pas rendue publique.
Les centres de données qui hébergent ces modèles sont, eux, soumis depuis plus longtemps à un cadre réglementaire européen centré sur la transparence énergétique de l'infrastructure. La directive (UE) 2023/1791 relative à l'efficacité énergétique impose la collecte et la publication de données sur la performance énergétique et l'empreinte hydrique des centres de données, selon un modèle commun à toute l'Union européenne. Le règlement délégué (UE) 2024/1364 du 14 mars 2024 précise les indicateurs à déclarer et leur méthode de calcul. Cette obligation s'applique aux salles informatiques dont la puissance installée dépasse 500 kW : le premier rapport était dû le 15 septembre 2024, les suivants doivent l'être chaque année, au 15 mai. Au niveau national, le référentiel volontaire AFNOR Spec 2314 « IA frugale » (juin 2024) complète ce cadre réglementaire d'une méthodologie et de bonnes pratiques pour mesurer et réduire l'empreinte environnementale d'un système d'IA.
Ce cadre reste récent et ne couvre pour l'instant que la transparence (publication de KPI côté centres de données, documentation transmise aux autorités mais non publiée côté fournisseurs de modèles), pas de seuil d'émission à respecter. Il constitue néanmoins la première brique d'une mesure standardisée de l'empreinte des infrastructures et des modèles qui portent l'IA à l'échelle européenne.
Comptabiliser l'IA dans le bilan carbone de son entreprise
Pour une entreprise qui utilise des outils d'IA générative (assistants conversationnels, agents intégrés à ses logiciels métier, API de modèles tiers), cette consommation ne relève ni du scope 1 ni du scope 2 de son propre bilan carbone : elle n'exploite pas elle-même les serveurs. Ces services relèvent du scope 3, et plus précisément de la catégorie « achats de biens et de services » du GHG Protocol, au même titre que n'importe quelle prestation numérique sous-traitée (hébergement cloud, logiciels en mode SaaS).
En pratique, ce poste reste aujourd'hui rarement isolé : la plupart des entreprises qui mesurent leur empreinte carbone appliquent un facteur d'émission monétaire global à l'ensemble de leurs achats de services numériques (cloud, logiciels, IA confondus), faute de données plus fines fournies par leurs fournisseurs. La Base Empreinte de l'ADEME permet cette approche par défaut, en convertissant un montant dépensé en ordre de grandeur d'émissions.
Une plateforme comme Orki, qui intègre des agents IA dans son propre module d'analyse du cycle de vie pour automatiser une partie de la collecte et de la modélisation des données, applique ce même principe à son usage interne : la consommation de ces agents entre dans le même cadre de mesure que n'importe quel autre poste du scope 3 numérique.
Réduire son empreinte IA : les leviers disponibles
Pour une entreprise utilisatrice, plusieurs leviers permettent de réduire ce poste sans renoncer à l'usage de l'IA :
- Choisir la taille de modèle adaptée à la tâche. Un modèle plus petit, spécialisé sur une tâche précise, consomme nettement moins qu'un modèle généraliste surdimensionné pour la même tâche.
- Limiter les requêtes redondantes. Mettre en cache les réponses à des questions récurrentes évite de solliciter le modèle à chaque nouvelle requête identique.
- Choisir la région d'hébergement de ses services IA. Quand le fournisseur le permet, héberger le traitement dans une zone au mix électrique largement décarboné (la France en fait partie) pèse souvent plus lourd sur l'empreinte carbone que les autres leviers pris isolément.
- Privilégier les fournisseurs qui publient leurs propres indicateurs. La publication volontaire de chiffres par requête ou par analyse de cycle de vie (à l'image de Google, d'OpenAI ou de Mistral AI) permet, à défaut de norme unique, de comparer les options disponibles sur une base au moins déclarative.
- Intégrer le poste dans le dialogue fournisseur. Demander à ses prestataires cloud et IA leurs propres données de performance énergétique (celles que la directive européenne impose déjà aux centres de données, et que l'AI Act impose désormais aux fournisseurs de modèles) plutôt que de se contenter d'un facteur monétaire moyen.
Conclusion : 5 points à retenir
- L'impact environnemental de l'IA recouvre deux postes distincts. L'entraînement des modèles, ponctuel et très énergivore, et l'inférence (l'usage quotidien), modeste à l'unité mais massive en volume cumulé.
- Les centres de données dédiés à l'IA pèsent déjà environ un tiers de la consommation électrique mondiale des data centers. Environ 155 TWh sur 485 TWh en 2025, une part appelée à tripler d'ici 2030 (AIE).
- La France suit la même trajectoire, à son échelle. De 10 TWh aujourd'hui à 23-28 TWh en 2035 selon RTE, une croissance tirée en bonne partie par l'IA.
- Les centres de données et les fournisseurs de modèles sont déjà réglementés ; l'usage de l'IA par l'entreprise ne l'est pas encore directement. La directive européenne sur l'efficacité énergétique impose depuis 2024 un reporting standardisé aux exploitants de data centers, et l'AI Act impose depuis août 2025 aux fournisseurs de modèles de documenter (sans obligation de publication) la consommation d'énergie de l'entraînement.
- Pour l'entreprise utilisatrice, ce poste relève du scope 3. Rarement isolé à ce jour, il peut être mesuré par approche monétaire via la Base Empreinte ADEME, en attendant des données fournisseurs plus précises.
Sources
- [Agence internationale de l'énergie (AIE/IEA)] — Key Questions on Energy and AI, World Energy Outlook Special Report. https://www.iea.org/reports/key-questions-on-energy-and-ai — Consulté le 5 octobre 2026.
- [RTE (Réseau de transport d'électricité)] — Bilan prévisionnel de l'équilibre offre-demande d'électricité 2025-2035 ; Les data centers en chiffres clés. https://www.rte-france.com/bases-electricite/consommation-electricite/essor-data-centers-france — Consulté le 5 octobre 2026.
- [OpenAI] — Sam Altman, billet de blog sur la consommation d'une requête ChatGPT, 10 juin 2025. https://blog.samaltman.com/the-gentle-singularity — Consulté le 5 octobre 2026.
- [Google] — Measuring the environmental impact of AI inference, rapport technique, août 2025. https://cloud.google.com/blog/products/infrastructure/measuring-the-environmental-impact-of-ai-inference — Consulté le 5 octobre 2026.
- [Patterson, Gonzalez, Le et al.] — Carbon Emissions and Large Neural Network Training, arXiv:2104.10350, avril 2021. https://arxiv.org/abs/2104.10350 — Consulté le 5 octobre 2026.
- [Mistral AI, avec Carbone 4 et l'ADEME] — Our contribution to a global environmental standard for AI : analyse de cycle de vie de Mistral Large 2, 22 juillet 2025. https://mistral.ai/news/our-contribution-to-a-global-environmental-standard-for-ai — Consulté le 5 octobre 2026.
- [Union européenne / EUR-Lex] — Règlement (UE) 2024/1689 (AI Act), article 53 et annexe XI, obligations des fournisseurs de modèles d'IA à usage général, applicable depuis le 2 août 2025. https://eur-lex.europa.eu/legal-content/EN/TXT/?uri=CELEX:32024R1689 — Consulté le 5 octobre 2026.
- [Commission européenne / EUR-Lex] — Directive (UE) 2023/1791 relative à l'efficacité énergétique ; Règlement délégué (UE) 2024/1364 du 14 mars 2024. https://eur-lex.europa.eu/eli/dir/2023/1791/oj?locale=fr — Consulté le 5 octobre 2026.
- [AFNOR] — Référentiel général pour l'IA frugale, AFNOR Spec 2314, juin 2024. https://www.afnor.org/actualites/intelligence-artificielle/referentiel-reduire-impact-environnemental-ia/ — Consulté le 5 octobre 2026.
- [Orki] — Empreinte carbone du numérique : impacts réels et leviers pour les entreprises. https://orki.green/article/impact-environnemental-de-la-tech-et-du-numerique — Consulté le 5 octobre 2026.
- [Orki] — Scope 1, 2, 3 : comprendre les 3 périmètres du bilan carbone. https://orki.green/article/scope-1-2-3-decryptage — Consulté le 5 octobre 2026.
- [Orki] — Scope 3 : définition, 15 catégories, calcul et réduction. https://orki.green/article/decarboner-sa-chaine-de-valeur-comment-reduire-le-scope-3 — Consulté le 5 octobre 2026.